笠原一輝のユビキタス情報局
キャッシュを減らして速くする。新Oryonの発想をSnapdragon取材で読み解く
2026年10月2日 06:07

Qualcommは、9月22日から9月24日(米国時間)に米国ハワイ州マウイ島で開催した同社の年次イベント「Snapdragon Summit」において、同社のフラグシップスマホ向け新製品となる「Snapdragon 8 Elite Extreme Gen 6」および「Snapdragon 8 Elite Gen 6」を発表した。
発表時には詳細などは明らかになっていなかったが、Snapdragon Summit中のさまざまな取材を通じてその詳細が明らかになってきたので、そのアーキテクチャ上の詳細などに関して解説していきたい。
前世代の改良版だが、プロセスノードが2nmに進化

今回発表されたSnapdragon 8 Elite Extreme Gen 6およびSnapdragon 8 Elite Gen 6の大まかな特徴を一文で表現すれば、「前世代の改良版だが、プロセスノードが2nmに進化」ということになるだろう。後述する通り、CPU、GPU、NPU、それぞれすべてが前世代の改良版になっており、アーキテクチャが大きく改善された部分は基本的にはないからだ。
以前のQualcommは、CPUのデザインは毎年変えていた。正確には、Armが提供しているIPデザインであるCortexシリーズをCPUの基本デザインとして採用しており、ArmのCortexシリーズは年次リリースとなっているため、それに伴って進化してきたというのが正しい表現だろう。
| ブランド | Snapdragon 8 Elite Extreme/8 Elite Gen 6 | Snapdragon 8 Elite Gen 5 | Snapdragon 8 Elite | Snapdragon 8 Gen 3 | Snapdragon 8 Gen 2 | Snapdragon 8 Gen 1 |
|---|---|---|---|---|---|---|
| 発表年 | 2026年 | 2025年 | 2024年 | 2023年 | 2022年 | 2021年 |
| CPUブランド名 | Oryon CPU | 第3世代Oryon CPU | 第2世代Oryon CPU | 新Kryo | 新Kryo | 新Kryo |
| Arm ISA | Armv8 | Armv8 | Armv8 | Armv9 | Armv9 | Armv9 |
| プライムコア | Oryon/プライム(2)/5GHz | Oryon/プライム(2)/4.6GHz | Oryon/プライム(2)/4.32GHz | Cortex-X4(1) | Cortex-X3(1) | Cortex-X2(1) |
| 高性能コア | Oryon/パフォーマンス(6)/4GHz | Oryon/パフォーマンス(6)/3.6GHz | Oryon/パフォーマンス(6)/3.53GHz | Cortex-A720(5) | Cortex-A715(2)/A710(2) | Cortex-A710(3) |
| 高効率コア | - | - | - | Cortex-A520(2) | Cortex-A510(3) | Cortex-A510(4) |
| L2キャッシュ(Oryon以降) | 16MB(共有) | 24MB(12MB+12MB) | 24MB(12MB+12MB) | ー | ー | ー |
| L3キャッシュ(Oryon以前) | - | - | - | 12MB | 8MB | 6MB |
| GPUブランド名 | Adreno 850 | Adreno 840 | Adreno 830 | Adreno 750 | Adreno 740 | Adreno 730 |
| メモリ種類/データレート | LPDDR5X/LPDDR6-5300 | LPDDR5X-5300 | LPDDR5X-5300 | LPDDR5-4800 | LPDDR5-4200 | LPDDR5-3200 |
| NPU | 新Hexagon NPU | 新Hexagon NPU | 新Hexagon NPU | 新Hexagon NPU | 新Hexagon DSP | 新Hexagon DSP |
| ISP | 新Spectra | 新Spectra | 新Spectra | 新Spectra | 新Spectra | 新Spectra |
| モデム | X105(内蔵5G) | X85(内蔵5G) | X80(内蔵5G) | X75(内蔵5G) | X70(内蔵5G) | X65(内蔵5G) |
| Wi-Fi/BT | FastConnect 8800 | FastConnect 7900 | FastConnect 7900 | FastConnect 7800 | FastConnect 7800 | FastConnect 6900 |
| 製造プロセスルール | 2nm(TSMC) | 3nm(TSMC) | 3nm(TSMC) | 4nm(TSMC) | 4nm(TSMC) | 4nm(Samsung) |
実際、初代Snapdragon 8となるSnapdragon 8 Gen 1からSnapdragon 8 Gen 3まではArmのCortexシリーズが採用されていた。プライムコア、高性能コア、高効率コアの3つのCPUコアから構成されており、それぞれCortex-X、Cortex-A7xx、Cortex-A5xxが採用されてきた。
それが大きく変わったのが、2024年に発表されたSnapdragon 8 Eliteだ。これには、Qualcommが買収したNUVIAのCEOだったジェラード・ウイリアムズ氏(既にQualcommを退社)がリーダーとなって自社設計した「Oryon」がアーキテクチャとして採用されている。
Oryonは、これまでのQualcommの前例(まずはスマートフォン向けで採用され、その後PCや自動車などに横展開)にはなかった、PC用(初代Snapdragon X)で先に採用され、その後2024年にスマートフォン向けに展開されたものだ。

Oryonの特徴は、シングルスレッドの性能をほかのPC用x86プロセッサ並みに引き上げ、同時にPC用はプライムコアだけで12コア構成にするなどして、マルチスレッド時の性能も高めた点にある。従来のPC向けArmプロセッサでは実現できていなかった高性能を実現しつつ、x86で実現が難しい低消費電力化による長時間バッテリ駆動を実現した。

Snapdragon 8 Eliteに搭載されたOryonは、Qualcommが第2世代のOryonと呼んでいるもので、高性能コアと組み合わせた伝統的なArmプロセッサの構成(いわゆるbig.LITTLE構成)になっている。プライムコアではシングルスレッド性能を稼ぎ、マルチスレッド時にはプライムコア+高性能コアで動作。そしてアイドル時などには高性能コアだけで動作することで、長時間バッテリ駆動を実現する仕組みだ。
そして昨年(2025年)発表されたSnapdragon 8 Elite Gen 5では、Qualcommが第3世代と呼んでいるOryonが採用された。アーキテクチャ的には第2世代との違いはなく、事実上クロック周波数が引き上げられたものとなる。プライムコアは最大4.32GHzから最大4.6GHzに、高性能コアは3.53GHzから3.6GHzに引き上げられた。
新Oryonは16MBの共有L2キャッシュに

では今年(2026年)発表されたSnapdragon 8 Elite Extreme Gen 6およびSnapdragon 8 Elite Gen 6はどうかというと、「Oryon」とだけ呼ばれ、世代名は付かないことになった。こうしたネーミングルールの「揺れ」はQualcomm製品ではよくあることで、今回も唐突に世代名表記がなくなった。
そのマーケティング上の理由はともかく、アーキテクチャ的にはどうなのかというと、実は今年はアーキテクチャ上の小改良が加えられている。それがL2キャッシュの構造だ。
QualcommのOryon CPUが高性能な秘密は、実はキャッシュ構造にある。

詳しくはSnapdragon 8 Eliteを解説した上記記事をご参照いただきたいが、その中で当時のOryonチーフ・アーキテクトであったウイリアムズ氏自身が、キャッシュ構造をL1、L2だけと簡略化し、プリフェッチなどを高速化することで、IPC(クロックあたりの命令実行数)を高めるデザインだと説明している。
Oryon CPUはモダンなCPUでは一般的なL3に相当するキャッシュがない。L2キャッシュを大容量化することで、メモリレイテンシ削減を狙ったアーキテクチャだからだ。従来のスマートフォン向けの第2世代Oryon、第3世代Oryonでは、このL2キャッシュは、CPUクラスタ(プライムコア2コアが1つのクラスタ、高性能コア6つが1つのクラスタ)に、それぞれに12MBを搭載していた。

それに対して今回の新Oryonでは、2つのクラスタが共有する16MBキャッシュになっている。従来は12MB×2で24MBのL2キャッシュだったのだから、容量だけをみればやや後退なスペックに見えるかもしれない。しかし、実際には共有キャッシュなので、1つのクラスタからみれば、最大容量は12MBから16MBに増えていることになる。
特にシングルスレッド時には、CPUコアは1つしか動いていないので、むしろ容量が増え、メモリレイテンシの削減につながる可能性が高い。逆にマルチスレッド時に、すべてのCPUコアが動作しているような場合には性能が低下する可能性はある。
ただ、マルチスレッド時には、たとえばCPUで動画のエンコードなどをする場合を考えれば、大量のデータを読み込んでくるため、キャッシュにはほぼ入りきらないので、実のところシングルスレッド時のキャッシュ容量こそ大事だと考えれば、この16MBの共有キャッシュというデザインは理に適ったものだ。
このデザインのメリットは、CPUにおいて大きな面積を占めるキャッシュの面積を減らせることだ。それにより、消費電力の低減や、何より製造コストの改善が実現されることで、その意味でも理に適ったデザインだといえる。
クロック周波数はプライムコアが5GHz、高性能コアが4GHzに引き上げられる

なお、今回Qualcommはプライムコアが5GHz、高性能コアが4GHzというクロック周波数に関しては盛んにアピールしたが、性能に関してはほとんどアピールしなかった。
ここ数年のQualcommは、Snapdragon Summitの基調講演などの機会を通じて、「前世代に比べて〇〇%向上」のようなメッセージを打ち出すことがほとんどだ。たとえば、昨年のSnapdragon 8 Elite Gen 5ではシングルスレッドが20%、マルチスレッドが17%という数字を何度か掲げていた。今回QualcommはCPUの性能に関して、まとめスライドの中で「前世代に比較してシングルスレッド13%、マルチスレッドで15%」と記載しただけで、非常にあっさりとしたものだった。

以前も別の記事で述べたと思うが、半導体メーカーのマーケティングというのは、「うそは言わないが、すべて本当のことも言わない」というのが基本だ。Qualcommに限らず、どこのメーカーもそうしているのが実態だ。
筆者のような記者側からすれば、何を言ったのかはもちろん大事だが、何を言わなかったのかももちろん大事だということだ。今回のようにQualcommはあまり性能をアピールしなかったということは、「例年のように性能の向上幅はあまり大きくないということの裏返し」だと受け取るのが正しい理解だろう。
なお、CPUのクロックがモバイルCPUとして初めて5GHzに達したというのはもちろん重要なマイルストーンだが、アーキテクチャは基本的に変わっておらず、L2キャッシュが調整された程度であることを考えると、5GHzを実現できた理由はTSMCの2nmで製造されているという、プロセスノード微細化の恩恵だと考えられる(前世代まではTSMC 3nm)。
GPUは性能44%向上、NPUにはエレメント・アクセラレータを追加

GPUの進化に関しては、すでに先週の記事で、Adreno 850とその特徴であるAdreno Neural Fusion(ANF)に関して説明しているので、そちらをご参照いただきたい。今回QualcommはAdreno 850のグラフィックス性能が44%向上し、電力効率は40%改善していると説明している。CPUに関してはほとんど性能向上に言及していないのに比べるとコントラストのある対応だ。
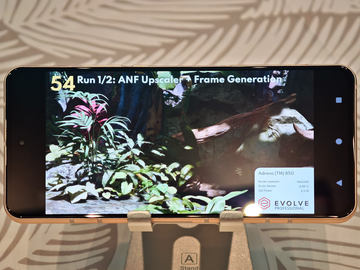
一方、NPUに関しては、Qualcomm Technologies AI製品担当副社長のビネッシュ・スクマール氏は「NPUには、新しいエレメント・アクセラレータ(Element Accelerator)が追加されている。さらにNPUのローカルメモリは容量が50%増えている」と述べた。


エレメント・アクセラレータは、LLMのような最新AIモデルで多く採用されている手法であるMoE(Mixture of Experts)モジュールの動作を高速化するものだ。MoEはアクティブなパラメータ数を増やさなくても高速な処理が行なえる手法だ。Qualcommのエレメント・アクセラレータは最大で32Kのコンテキスト長(約60ページの文章に相当する)に対応することが可能で、300億を超えるパラメータのMoEモジュールを処理することができるという。
従来世代のNPUでは最大で16K(約25ページ相当)のコンテキスト長にのみ対応可能だったため、一度に倍以上のコンテキスト長をローカルで処理できるようになったといえる。
なお、エレメント・アクセラレータ以外の演算器は、基本的に従来のNPUと同じだ。スカラーは12基、ベクターは8基、テンサーは1基というのがその構造で、そこにエレメント・アクセラレータが1基加わったことになる。
ISP(Image Signal Processor)になるSpectra ISPも基本的には従来製品の改良版となる。ハードウェアそのものは20bitのISPが3ユニットと構造は変わっていない。ゼロシャッターラグで3つのカメラが同時に撮影できるHDR映像は、6,400万画素まで高められている。
このように、大きな変化はないが、細かな所のスペックが上がった、それが新しいSpectra ISPの実態だといえる。こちらも、ISP自体が進化したというよりは、2nmへの微細化の恩恵と考えるのが正しいだろう。
Snapdragon 8 Elite Extreme Gen 6は「Offset PoP」という新しいパッケージを採用

今回Qualcommは「2つのフラグシップ製品」として、Snapdragon 8 Elite Extreme Gen 6とSnapdragon 8 Elite Gen 6の2つを発表した。
従来はSnapdragon 8 Elite Gen 5がフラグシップで、その1つ下にハイエンド向けと位置づけられる「Snapdragon 8 Gen 5」があるという構造になっていた。今回は「Snapdragon 8 Gen 6」は発表されず、Snapdragon 8 Elite Extreme Gen 6とSnapdragon 8 Elite Gen 6が2つともフラグシップとされた形だ。

Qualcomm上席副社長兼携帯電話事業部長のクリス・パトリック氏は「今回2つの製品をフラグシップ向けとしたのは、OEMメーカーからそうしてほしいという要求があったからだ」と述べた。
それを裏付けるかのように、Snapdragon Summitの基調講演でXiaomiは、上位モデルの「Xiaomi 18 Pro Max」にはSnapdragon 8 Elite Extreme Gen 6を、「Xiaomi 18 Pro」にはSnapdragon 8 Elite Gen 6を採用した。Xiaomiにしてみれば、フラグシップであるXiaomi 17 Ultraに上位のSoCを搭載し、下位モデルとは差別化したい、そうした意図が透けて見える。

パトリック氏によれば、Snapdragon 8 Elite Extreme Gen 6とSnapdragon 8 Elite Gen 6のダイは別だという。Snapdragon 8 Elite Extreme Gen 6だけのハードウェア機能として、GPUの新機能(マトリックスコア、ANF、18MB HPM)、NPUの新機能(エレメント・アクセラレータ、共有メモリ50%増)、ISPの新機能(8K/60fpsの動画撮影など)などを挙げている。製造コストのことを考えて、これらの機能を省いたダイをSnapdragon 8 Elite Gen 6用として用意したとのことだ。
また、Snapdragon 8 Elite Extreme Gen 6だけの特徴として、新しいパッケージとなる「オフセット・パッケージ・オン・パッケージ」(Offset Package on Package、以下Offset PoP)を採用している点が挙げられる。
従来のSnapdragon製品では、PoP(Package on Package)と呼ばれる方式でDRAMをパッケージ上に搭載していた。いわゆる3D方向のチップレットという形になっていた。
このOffset PoPでは、3D方向のチップレットを維持しながら、2つのチップが完全に重ならないように少し位置をずらして搭載する。SoCのダイの上にサブストレート基板が被せられ、その上にLPDDR5/6などのDRAMを搭載する形で、ダイの熱が外部に放熱しやすくなる。従来のパッケージに比較して、SoCの性能を2倍長く維持しやすくしたとしている。
いずれにしても、新製品の特徴はTSMCの2nmプロセスノードで製造されていることだ。CPUとNPUは進化版であり、GPUに関してはマトリックスコアとそれに由来する超解像+フレーム生成技術のANFが大きな進化点といえるだろう。その意味では、特にSnapdragon 8 Elite Extreme Gen 6に関してはAndroidでゲームを多くプレイするゲーマーにこそおすすめできる製品といえる。
Windowsの異種混合プロセッサ環境で、AIソフトウェアを効率よく実行するModularの取り組み

最後に、やや蛇足になるが、今回のSnapdragon Summitで紹介されたModular(モジュラー)について説明しておきたい。ModularはQualcommが6月に買収したスタートアップのソフトウェア企業だ。


ざっくり言うと、Modularは各半導体メーカーが提供している演算用のAIソフトウェア(たとえばNVIDIAならCUDA、AMDならROCm、QualcommならQNNなど)の違いを吸収するものだ。ハードウェアの上に「Mojo」と呼ばれるプログラミング言語のレイヤーが設けられ、そこでハードウェアの違いを吸収。その上に「Max」と呼ばれるAPI層、「Modular Cloud」と呼ばれるソフトウェア層が用意されており、クラウドのソフトウェアからはMaxのAPIを叩くことで、各社のハードウェアを利用して演算を行なう仕組みになっている。
誤解を恐れずにPCでのソフトウェアにたとえるとすれば、Direct3DやOpenGLのようにGPUのハードウェアを抽象化するソフトウェアレイヤーのAI版だ。

Modular共同創業者兼CEOで、Qualcommによる同社買収後はQualcomm AIソフトウェア・プラットフォーム担当上席副社長となったクリス・ラトナー氏は「Qualcommとは以前からDragonflyブランドのAIアクセラレータをModularに対応させるなど協力してきた。今後はQualcommと協力をさらに深めて、業界全体で異種混合のプロセッサをAIソフトウェアが簡単に使えるオープンな環境を構築していきたい」と述べた。
現在進行中のプロジェクトとして、MicrosoftがMojoをWindowsでネイティブサポートすると、同社が8月に開催したカンファレンスで発表したことを紹介した。将来的にWindowsにModularの仕組みが導入され、ソフトウェアからどのベンダーのGPUであろうが、NPUであろうが最適なハードウェアが自動的に選択されて実行されていくようになる可能性がある。
現状、ソフトウェアの開発者が、WindowsにあるさまざまなCPU、GPU、NPUなどの存在を意識しながらプログラムを書く必要がある。そのためAIアプリケーションはGPUだけ、あるいはNPUだけを使って演算していて、複数種類があるプロセッサを有効活用できない現実がある。WindowsへのModular導入によりその状況が大きく改善される可能性がある。
WindowsでのModularのサポートは、今日明日に有効になるという話ではないと思われるが、長期的に見るのであれば非常に重要な取り組みであり、要注目だ。