ニュース
脱GPUへ一手、Googleが独自AIチップ「TPU」に新モデル2種
2026年11月9日 22:00

Googleのクラウドサービス事業部門となるGoogle Cloudは11月9日(米国時間)、AI演算装置であるTPU(Tensor Processing Unit)の最新製品「TPU 8tx」と「TPU 8i Max」を発表した。TPUは、同社が社内のAI環境(一般消費者向けのGeminiや法人向けGemini Enterpriseなど)やクラウドサービス事業の顧客向けに提供しているもの。
両製品ともに、4月にGoogle Cloudが発表した第8世代TPU(「TPU 8t」、「TPU 8i」)のバリエーション。TPU 8txは、TPU 8tとAMDの第5世代EPYCが備えるConfidential Computing機能を統合した製品。TEE(Trusted Execution Environment、信頼できる実行環境)を作り出して処理をその中で実行することで、外部からの干渉を防ぎ、高いセキュリティ性を実現できる。
TPU 8i Maxは、1つのパッケージ上に2つのTPU 8iを統合した製品。ラックあたりに格納できるTPUの密度を2倍にすることで、ラック全体でのコンピューティング性能やメモリ容量を2倍にできる。
第8世代TPUは、4月の発表後にGoogle自社のデータセンターへの納入が進んでいる。10月にはOracleのクラウドサービス事業であるOCI(Oracle Cloud Infrastructure)と、ほかのハイパースケーラーのクラウドサービス事業者での採用も決まった。今回の2製品は、その普及をさらに後押しするものだ。
採用が拡大するGoogle CloudのTPU

AIの分野では「誰がどれだけの処理能力をいくらで得るのか」が競争になりつつある。たとえば、10月27日にラスベガスで行なわれたOracle AI Worldにおいて、OCIの事業責任者であるマヘシュ・シャガラジャン氏は、OpenAIが9月に発表したフロンティアAIモデル「GPT-6 Astra」の学習や開発などが、OCIがOracleのデータセンターに構築しているGPUクラスターで行なわれたことを明らかにしている。同氏は、OpenAIやAnthropicなどが繰り広げている最先端モデルの開発について、「最先端のモデルにはそれなりの演算インフラが必要だ」と述べ、大規模な演算インフラの重要性を強調している。
OpenAIやAnthropicといった新興のAIソフトウェアベンダーは、OCIのようなハイパースケーラーのクラウドサービス事業者のインフラを大規模に借りて、AI学習を行なうことが一般的だ。それに対してGoogleは、自社内にGoogle Cloudというクラウドサービス事業者を持っていることもあり、基本的には自社のインフラを使って開発を行なっている。
Googleは割合こそ公開していないが、そうしたAI演算のインフラの一部として自社開発のカスタムチップであるTPUを利用している。Googleは、このTPUを2015年以来AI演算インフラの一部として使ってきた。当初は推論向けの専用エンジンという目的で開発されたのだが、その後学習用が投入され、近年は推論に特化したモデルに回帰している。
Google CloudがこうしたTPUに力を入れる理由は2つある。1つは、学習用としては高い市場シェアを持つGPUの入手困難に対応するため。そしてもう1つは、GPUの価格が高騰傾向にあるため。つまり、性能あたりの単価が安い自社チップを導入することで、コストを下げることを目指してきた。
そして、今年(2026年)の4月に行なったGoogle Cloud Next'26で発表したのが第8世代TPUだ。TPU 8tは学習、TPU 8iは推論にフォーカスしたもので、それぞれ目的に応じて利用できる。

TPUはこれまで事実上Googleのクラウドでのみ提供されてきたが、Oracleは10月に開催したOracle AI Worldにおいて、自社のデータセンターにTPUを導入すると明らかにした。
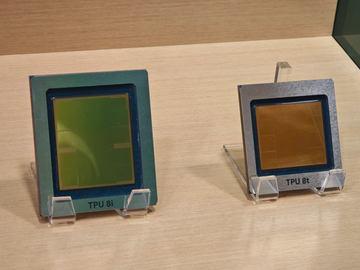
TEEをEPYCで実現したTPU 8txと密度2倍のTPU 8i Max

Googleは今回、こうしたTPUのラインナップを拡充する。TPU 8txはTPU 8t、TPU 8i MaxはTPU 8iの派生モデル。いずれのチップそのものは基本的にTPU 8tおよびTPU 8iと同じだが、インフラ側に拡張が入る形になる。なお、Google Cloudによれば、1年間で4つのTPUを発表するというのはTPUの歴史の中でも初めてのことだという。

TPU 8tは、従来はGoogle Cloudがカスタムチップとして設計したArm ISAのCPUであるAxionと組み合わせて利用されてきた。それに対して新しいTPU 8txでは、CPUがAMDの第5世代EPYC(開発コードネーム: Turin)に変更された。これにより、第5世代EPYCで実装されているAMDのConfidential Computingのハードウェア(SEV)が作り出すTEEを利用できるようになる。
TEEは、ハードウェアの機能を利用してメモリ空間の中に信頼できる実行環境を作り出し、そのTEEのメモリ空間で動作するプログラムがマルウェアなどから影響を受けることを防ぐことができる。ソフトウェアだけだと、そうした環境を作ることは難しいのだが、ハードウェアの機能を利用することでTEEを作り出せる。
TPU 8txでは、AMD CPUを利用したTEEを作り出すことで、外部に漏れては困るAI学習用のデータなどを格納しながら実行できるようになる。大企業が安全な環境でAIモデルを開発したい場合などに、有望な選択肢となる可能性がある。

それに対してTPU 8i Maxでは、ラックあたりに格納できるTPUの密度を増やす。従来は1つのパッケージに1つのTPU 8iが実装されていたのに対して、1つのパッケージに2つのTPU 8iが実装される形になっている。
サーバーの1枚の基板には、従来は4つのTPU 8iが搭載可能だったのに対して、TPU 8i Maxでは8つが実装可能になる。これにより、1枚の基板に搭載できるTPU 8iのチップ数が倍になり、1つのラックに格納できるTPU 8iの数も従来の倍になる。シンプルにいえば、同じデータセンターの面積でも、TPU 8iをTPU 8i Maxに置きかえることで、理論的に性能が倍になるということだ。

また、Googleは4月のGoogle Cloud Next'26で発表していた「PyTorch on TPU」のGA(一般提供開始)も明らかにしている。PyTorch on TPUは、TPUがPyTorchにネイティブ対応し、CUDA向けに書かれたPyTorchのコードを簡単にTPU向けに書き換えることを可能にするというもの。
これにより、PyTorchで作成したAI学習のソフトウェアをTPU上で走らせやすくなり、CUDA GPUからTPUへの乗り換えがより容易になる。なお、PyTorch on TPUに関しての詳細は以前の記事をご参照いただきたい。

