西川和久の不定期コラム
9年前の「Tesla V100」がアツい。Qwen3.8-Flash-Nextが約80tok/s出る!
2026年10月14日 06:07

今月(2026年10月)の冒頭に、GeForce RTX 4090(48GB改)で「Qwen3.8-Flash-Next」(以下Flash Next)を動かす「Strata」をご紹介した。Strataは、GPUのVRAM、メインメモリ、SSDの3階層にエキスパートを置いて、巨大なMoE(Mixture of Experts)モデルを普通のPCで動かすエンジンだ。
今回は同じことを、中古で購入した「Tesla V100」でやってみたい。
NVIDIAのTesla V100とは?
NVIDIAのTesla V100(以下V100)は、Volta世代のGPUだ。メモリはHBM2で、帯域は約900GB/s。ほぼ同じ価格帯の現行GeForceより、メモリ帯域が広いのが特徴だ。LLMのデコード(出力)は、メモリ帯域がそのまま速度に出るので、ここが効いてくる。
V100のフォームファクタは2種類ある。
- PCIe版: 一般的なPCIeカード。普通のマザーボードにそのまま挿せる
- SXM2版: サーバー用のモジュール。ソケット式で、専用基板がないと使えず、PCIeで使う場合は変換するアダプタが必要
どちらも16GB版と32GB版がある。LLM用途では容量が効くため、16GBはあまり意味がなく、今回のような用途では32GB一択だ。
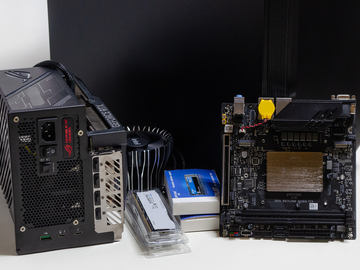
入手したのは、SXM2版をPCIeに変換するアダプタに載せたものだ。これなら、普通のPCIeスロットに挿せるようになっている。
また、V100は本来パッシブ冷却、つまりGPU本体にファンはない。PCIe版の場合は(SXM2版をPCIeに変換するアダプタは作り込みによる)、別途ファン用意し、強力なエアーを送り込む必要がある。


入手したのはご覧のように既にファンが搭載されていて、電源は12VHPWRまたはPCIe 8ピン2基の2系統(どちらか一方を使う)。つまりV100自体は300Wとなる。
なお、SXM2版の特徴であるGPU同士を直結するNVLinkは、この構成では使えない。モジュールを1枚ずつ別のアダプタに載せるため、NVLinkの配線がないからだ。
なお中古価格は、人気が出る前だと7万円程度だった。しかし今は人気が出てしまい11~12万円程度に値上がりしている(+円安)。とはいえ、HBM2で帯域は約900GB/sの32GB。一見かなりお買い得に見える。
ただ、大容量で高速なメモリ……という良い話ばかりではない。演算で対応するのは、FP32演算とFP16対応のTensorコアのみ。LLMで多く使われているINT8/BF16/FP8/FP4などには未対応。加えてすでに生産終了/サポート終了で環境が限定され、以下のような制限がある。
- ドライバは580系が最後: Volta世代に対応する最後のブランチ
- OSを新しくできない: 580系ドライバが新しいカーネルでビルドできなくなる恐れがある
つまりUbuntuは24.04のまま使い、26.04には上げない設定(Prompt=never)にしなければならない。カーネルも導入直後の7.0(HWE)から6.8に戻して固定。ドライバが580なので、CUDAは12.x止まり。CUDA 13ではVolta向けにコンパイルできない。
と、用途によってはかなり厳しい条件が付く。今回はLLM(主にStrataとその派生エンジン)が対象なので大丈夫だが、AI界隈の進化速度はかなり速く、この環境が何年持つかは不明……といったリスクがあり、それを承知で購入するなら……という感じだ。
参考までにV100以降、NVIDIAのGPUの歴史は、
| 世代(登場年) | 主な製品 | LLMに関わる進化 |
|---|---|---|
| Volta(2017) | V100 | Tensorコア(FP16)が初登場、HBM2 |
| Turing(2018) | RTX 20、Tesla T4 | TensorコアがINT8/INT4に対応、RTコア |
| Ampere(2020) | A100、RTX 30 | BF16/TF32、構造化スパースネス、HBM2e(A100) |
| Ada(2022) | RTX 40(4090)、L40S | FP8 Tensorコア |
| Hopper(2022) | H100/H200 | FP8とTransformer Engine、HBM3(H200はHBM3e) |
| Blackwell(2024~) | B200、RTX 50(5090)、DGX Spark(GB10) | FP4/FP6(NVFP4)、HBM3e(B200) |
と、ざっとこんな感じだ。つまりV100は5世代も前のGPUとなる。2017年でIntelのCPUだと第7世代Core(Kaby Lake)、第8世代Core(Coffee Lake)。手元に第8世代のCPUを搭載したノートPCがいくつかあるが、もうとっくに使っていない。
とはいえ、このような世代のGPUでも現在の技術で使うと、以降説明する数値を叩き出すのだから、いかにソフトウェアが重要なのかが分かる。
Strataのインストール(Ubuntu 24.04 + V100 x1)
前回はOCuLink付きのミニPCを使ったが、今回は以前RTX 4090が24GBだった頃(笑)、メインAI PC用のマザーボードを使用。RTX 5090を購入後に載せ替えお蔵入りしていた1つだ。またこのとき、主にモデル置き場として使っていた2TB NVMe SSDも復活させた。
| 項目 | パーツ |
|---|---|
| CPU | Core i7-12650H(AVX-512なし) |
| メモリ | 64GB(DDR4 32GB×2) |
| SSD | NVMe 2TB(M.2 2280スロット自体は3つある) |
| PCIe x16 | 1つ |
| OS | Ubuntu 24.04.5 LTS |
| LAN | Gigabit Ethernet、2.5Gigabit Ethernet |
| Secure Boot | オフ |
CPUもメモリ容量もちょっと物足りないが、とはいえこれだけいろいろ値上がりしている中、放置ももったいないところ。
当初バラックでセットアップや評価をしていたが、流石に見た目と収まりが悪かったので、オープンフレームケースを別途購入。天板も欲しかったので2組注文している。いろいろ付けたり外したりするのでオープンフレームケースの方が使いやすいだろうとの判断からだ(笑)。

オープンフレームケースなので組み立ては楽。机の上に置くのは厳しいが床の上に置くなら特に問題ないだろう。
さてハードウェア的にはOKなので次はソフトウェアのインストールとなる。以下、順を追って説明する。
1. 下準備
最小構成でUbuntuを入れたので、まず基本のパッケージを足す。
sudo apt install git curl build-essential cmake tmux htop aria2 python3-pip python3-venv pciutils
StrataはRAMを35~55GBロックするので、ロックできるメモリ量の上限(memlock)を外す。
/etc/security/limits.d/99-memlock.confに次の1行を書いて、再ログイン
knishika - memlock unlimited
2. ドライバとCUDA Toolkit
ドライバのインストールは、先に説明した通り580系が最終版となる。インストール後はいったん再起動。
sudo apt install nvidia-headless-580 nvidia-utils-580
sudo reboot
nvidia-smiでTesla V100-SXM2-32GBが見えれば成功。

次にCUDA Toolkit 12.9。NVIDIAの公式リポジトリ(cuda-keyring)を追加して、cuda-toolkit-12-9だけを入れる。ドライバが入れ替わらないよう、ツールキットだけを選ぶのがポイントだ。
sudo apt install cuda-toolkit-12-9
3. Strataを取得してセットアップ
ここまでが環境整備。これでやっとStrataをインストールできる。
mkdir -p ~/works && cd ~/works
git clone https://github.com/Niko1221/Strata.git
cd Strata
STRATA_NVCC=/usr/local/cuda-12.9/bin/nvcc ./setup.sh \
--family qwen --model IQ3_S --context 262144 \
--vision yes --kv int8 --host 0.0.0.0 --cuda 12 --yes --no-start
V100向けはビルド済みのエンジンがないため、ここでエンジンのコンパイル(275ステップ、約15分)が走る。そのあと、IQ3_Sのパック変換と、投機デコード用のMTPドラフト層(約5GB)の取得が続く。
完了すると、起動スクリプトrun-iq3_s.shと設定strata-iq3_s.jsonが出来上がる。モデルのファイル(IQ3_Sはモデル約79GBとMTPドラフト層約6.5GB)は、setup.shが自動で取得。
4. 起動
./run-iq3_s.sh
http://<IPアドレス>:8080/v1がOpenAI互換のAPI、同じアドレスをブラウザで開くとWebUIのチャットが使える。モデルIDはqwen3.8-flash-next-iq3_s。

Strataのベンチ(V100 x1)
Strataが動くようになったので、前回同様、Claude Codeにベンチマークテストをお願いした。結果は以下の通り。参考までにRTX 4090(48GB改)のスコアも併記した。none/lowはThinkingの設定だ。
| decode(tok/s、3回平均) | コード | 論理パズル | 文章生成 | 日本語 |
|---|---|---|---|---|
| V100 x1 (none) | 78.0 | 69.7 | 60.1 | 71.5 |
| V100 x1 (low) | 79.9 | 74.8 | 64.2 | 69.9 |
| 4090 48GB (none) | 98.2 | 102.9 | 80.7 | 92.6 |
| prefill(tok/s) | 約5.9 | 約23k |
|---|---|---|
| V100 x1 | 約985 | 約1,356 |
| RTX 4090 48GB | 約1,600 | 約2,800 |
※ただしRTX 4090の測定はv0.1.38、V100はv0.1.43。この間、結構速度が向上しているので参考まで
V100 x1のdecodeは、RTX 4090(48GB)の約0.7~0.8倍。prefillは約0.5~0.6倍だ。4090(48GB)という“改造版”と比べるのは酷だが、RTX 5060 Ti+RTX 4060 Tiの約38tok/sよりは約1.6~2.1倍速い。
これはいい意味で驚いた。RTX 4090(48GB)のざっくり4分の3ものデコード速度が出ていることになる。通常のRTX 4090(24GB)だとVRAMに重みが乗り切らない分、メインメモリへ回り込み=CPU演算、V100と同レベルか遅い可能性がある。
気を良くして、この状態で前回書いたMCPでのWeb検索機能も付けしばらく使っていたが快適!これでいいのでは?状態だ。
考えてみると2017年にリリースされた(32GB版は約1年後)V100が、10年近く経った今、ここまでの性能が出せるとは……。メモリやGPUなどAIに欠かせない資源不足の中、NVIDIAはサポート終了とはいわずもう少しサポートを続けてもいいのではないだろうか?
さて今回はV100を1枚だけ使ったのだが……実は2つ購入したのだ(笑)。次回は、V100を2枚でStrataを動かしたときの結果、加えて、V100が2枚でないと実用的な速度で動かない「Maya」――Strataと同じ仕掛けでGLM-5.3-Flashを実行するソフト――動かしてみたい。お楽しみに!